天台副歌
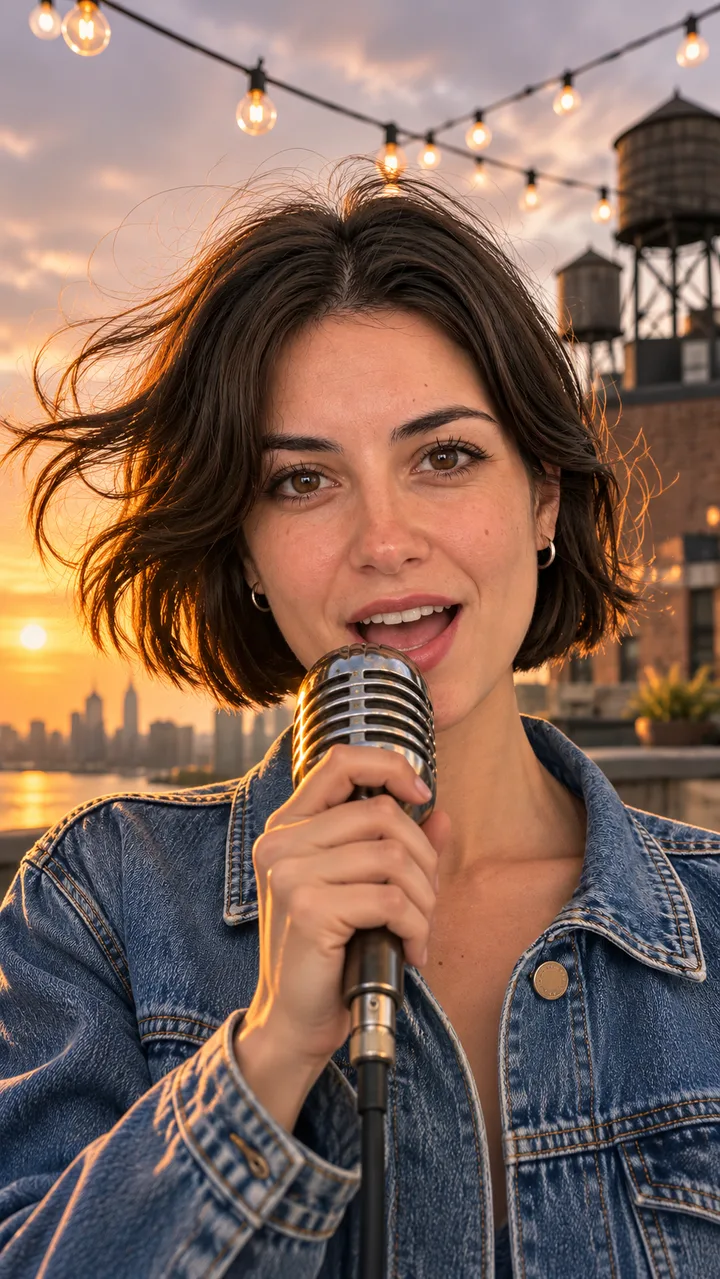
她背对低垂的夕阳,对着复古麦克风近景演唱;第 3 秒左右切到以楼群为背景的侧脸,最后拉成天台全景,头顶挂着串灯,远处是水边的城市。
Seedance 2.0 Fast 片段混剪 用这张照片上传照片,把参考方式切到多模态参考,在参考音频里放一段最长 15 秒的歌曲片段,点生成视频。还没有歌?去音乐里做一首 →
Seedance 2 Mini: text, frame and media reference video generation
Google 最新的模型,输出质量卓越
一张参考图时,Grok 视频会沿用图片比例。
参考视频的实际时长将计入 Seedance 和 MiniMax 的积分。文档最多 50 页。
启用此选项后,生成的视频可能会被 AI Generate 选中并发布到探索页面。
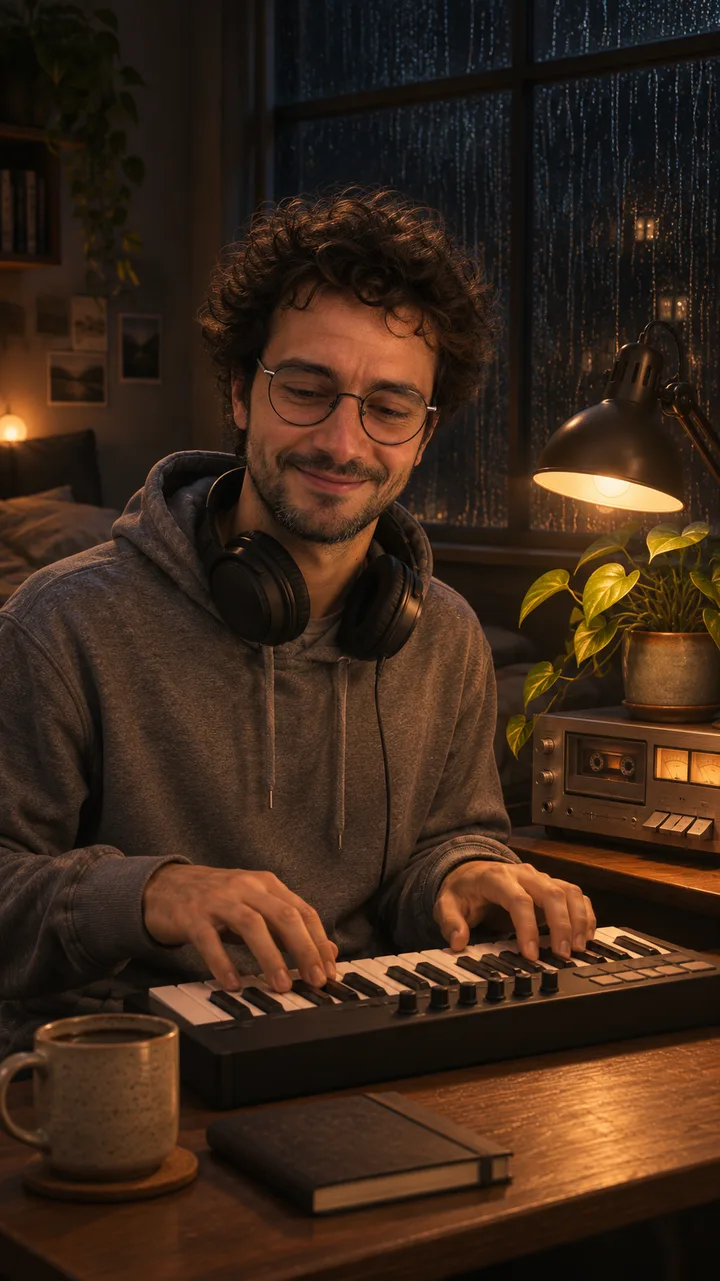
穿牛仔夹克的歌手在天台唱一段 synth-pop 副歌,戴圆框眼镜的制作人在卧室放一段 lo-fi 循环,都剪自带声音的 10 秒原片。
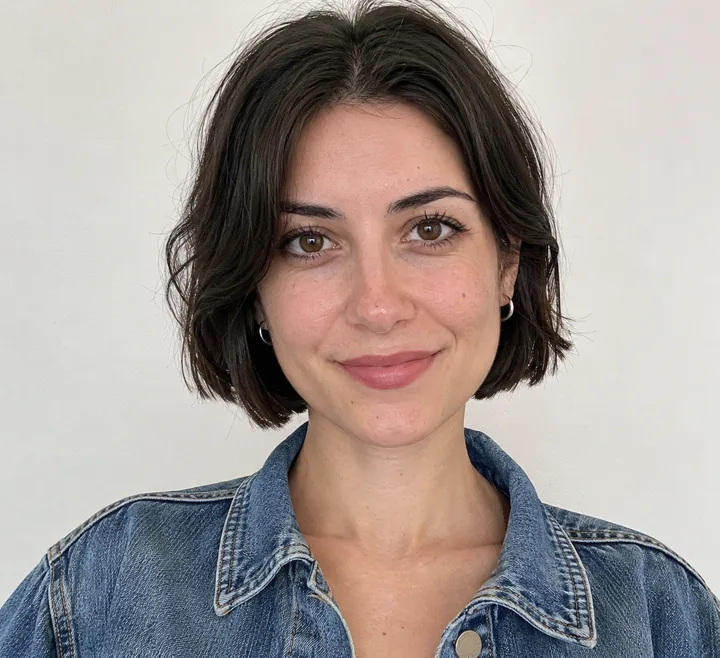
两条样例都从 AI 生成的原创成人肖像开始,不是真人。天台副歌:一位黑色短波波头、穿牛仔夹克的女性肖像,先做成日落天台的竖版定格;这张定格和 Rooftop Lights(原创 synth-pop 副歌,只唱“啦啦啦”没有歌词,118 BPM)的 12 秒片段一起作为参考交给 Seedance 2.0 Fast,2026 年 11 月 5 日返回一段带声音的 10 秒视频。
卧室 Lo-fi 走同样的流程:一位卷发、圆框眼镜、灰色连帽衫的男性,配 Lamp Light Loop(纯音乐 lo-fi,80 BPM)的 12 秒片段。两首歌都用 Suno V6 制作,就是你在音乐里能选的那个模型。
这里放的是每段原片的混剪:约 8.8 秒和 9.3 秒,轻微重构图,调了颜色和速度,没有镜像,左上角是 ghibliia.com 标记。声音保留了,但不是原歌:它是模型按片段生成的,变速后副歌约 117 BPM,循环约 81 BPM。视频默认静音,在播放器里打开声音即可。混剪没有花积分。用这张照片 →
上传照片,选多模态参考,在参考音频里放一段从重拍开始的 10 到 15 秒片段,点生成视频。
全部在上方工作台完成,默认打开的是 Seedance 2 Mini。Seedance 2 Mini 出 4 到 15 秒,Seedance 2.5 出 4 到 30 秒,两者都支持竖版 9:16。
在参考方式里把首尾帧换成多模态参考:两种方式不能在同一次生成里同时用,所以歌只能从这里放。照片放进参考图片,Seedance 2 Mini 最多 9 张。正脸、光线均匀的照片效果最好。想先做一张带场景的定格,可以去图像里做。
把片段放进参考音频,WAV 或 MP3,单个不超过 15 MB。Seedance 2 Mini 最多 3 段、合计 15 秒;Seedance 2.5 合计 30 秒。截 10 到 15 秒、从重拍开始的一段,比如副歌或鼓点进来的地方。还没有歌?去音乐里做一首。
在工作台上方选一个场景,保持“生成声音”勾选,点生成视频。生成前按钮会显示模型、时长和积分,完成后可以下载。生成视频 →
在音乐里选自定义,贴上歌词,写风格(比如 cumbia pop 或 lo-fi bolero),下载 MP3 用于视频。
音乐支持 Suno v3.5、v4、v4.5、v4.5 Plus 和 V6。你写的歌词归你;按美国版权局 2025 年 1 月 29 日发布的报告,纯 AI 生成的内容在美国不受版权保护。
简单模式只要一句描述。自定义有三个栏位:标题、风格、歌词。把主歌和副歌贴进歌词栏;每首歌都能下载 MP3。
在风格栏写曲风。下面三条可以直接复制:
想要没有人声的伴奏就打开纯音乐,和卧室 Lo-fi 那首一样:适合 Spotify Canvas 循环,或者不跟屏幕文字抢的背景。去音乐 →
它听你上传的片段,按片段的节奏让画面动起来,但视频里的声音是重新生成的:节奏保留,不是你那首歌的原样拷贝。
首尾帧模式不能带参考音频,所以整首歌要用多模态参考分段出片:前奏、主歌、副歌各一段,都用同一张照片。在剪辑软件里拼起来,把视频原声关掉,垫上你的原始 MP3,这样视频里听到的就是你的歌。用我的歌试试 →
TikTok 和 Reels 导出 9:16;YouTube Studio 里标注 AI 做的逼真音乐或场景;Spotify Canvas 用 3 到 8 秒、不唱歌的竖版循环。
竖版 9:16,就是视频出来的格式。在剪辑软件里把几段拼起来,歌词字幕也在那里加:工作台不会往视频里写字。
YouTube 要求在 YouTube Studio 标注逼真的修改或合成内容,包括作为视频主体的 AI 生成音乐。明显不真实或动画风格的画面不需要标注。
竖版 9:16 循环,3 到 8 秒,高 720 到 1,080 像素,MP4 或 JPG。Spotify 建议避开唱歌画面和快速剪切,所以像卧室 Lo-fi 这样安静的片段剪短后更合适。做我的视频 →
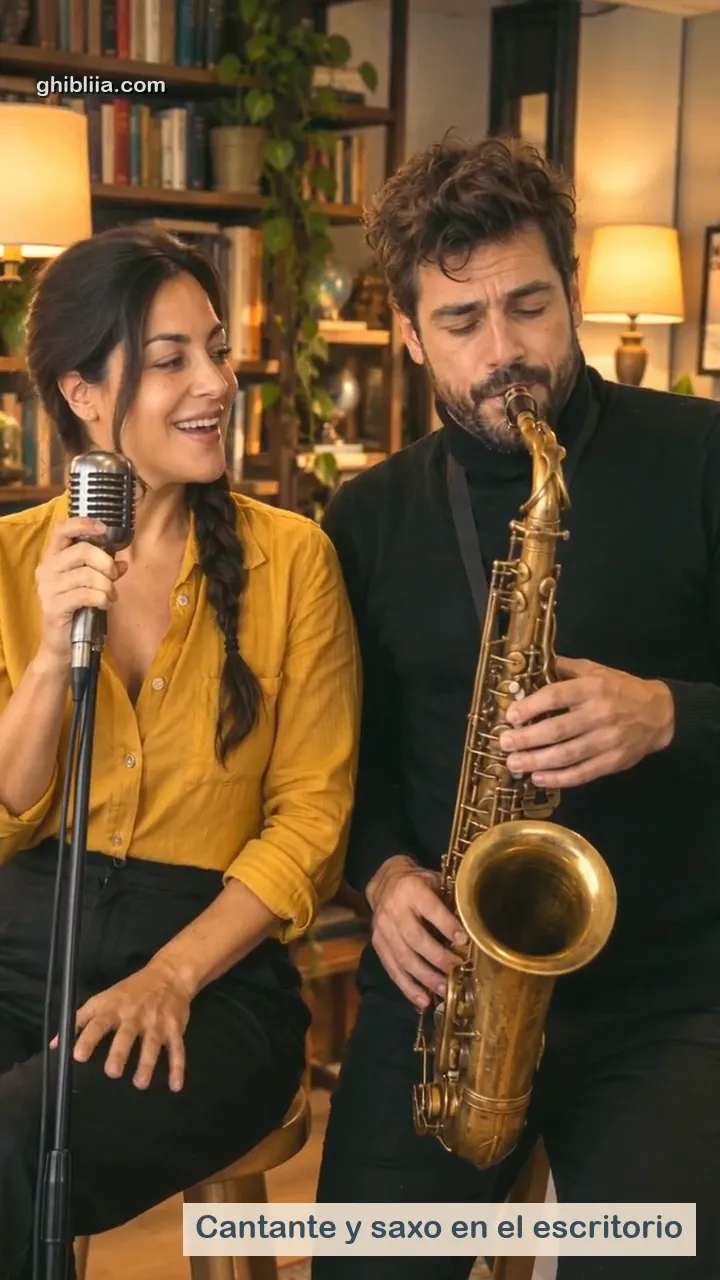
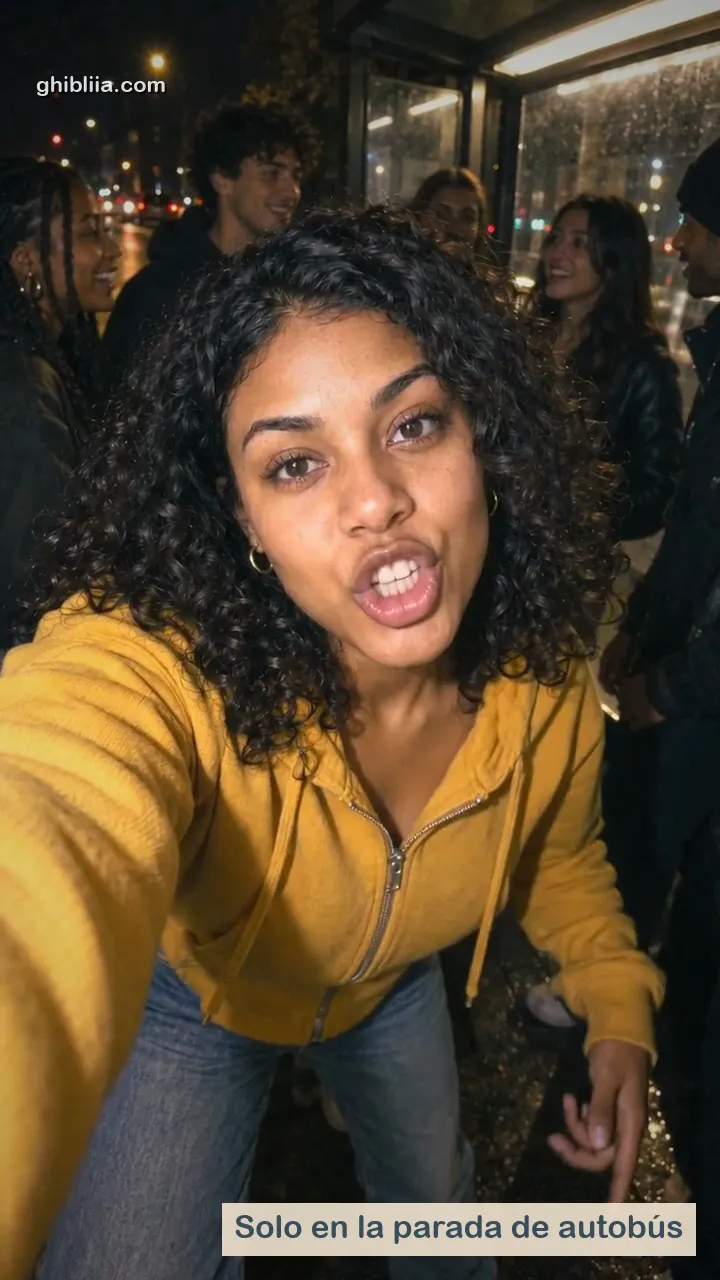
和朋友在办公桌前唱歌打开 Tiny Desk AI Video,试麦打开 Check One Check Two AI,弹钢琴打开 AI Piano Playing;用你自己的歌,就回到这个工作台。
你和朋友的办公桌演唱会:两张照片,一个主唱,一支萨克斯。打开 Tiny Desk AI Video →
夜里用广角自拍试麦,然后接上一段说唱。打开 Check One Check Two AI →
照片里的人坐到钢琴前弹起来。打开 AI Piano Playing →
一种工具:给它一首歌加一张图片或一种风格,它返回画面跟着音乐动的视频。专门的工具会先分析速度、拍点和段落;在这里,你把一段歌当参考音频上传。
HeyGen 不用绑卡就能免费开始,Freebeat 有带 500 积分的免费方案;免费方案一般会限制时长、分辨率或下载。在这里,每个按钮生成前都会显示积分。
单段视频 Seedance 2 Mini 是 4 到 15 秒,Seedance 2.5 最长 30 秒。整首歌要在剪辑软件里用多段拼起来,底下垫原始 MP3。
有参考音频时模型可以跟着人声走,像天台副歌那样;但唱歌的特写最难,中景效果更好。HeyGen 和 Neural Frames 有针对整首歌的对口型模板。
你写的歌词和你的录音归你。按美国版权局 2025 年 1 月 29 日的报告,纯 AI 生成的内容不受保护;你的歌词、录音或剪辑编排可以受保护。
每段都是一次新的生成。所有片段都用同一张照片当参考图片,并重复同样的服装和地点描述。